【前編】HPE ProLiant DL385 Gen10 に TITAN RTX を積んでローカル LLM サーバにした ─ 補助電源と電力上限の見極め
はじめに
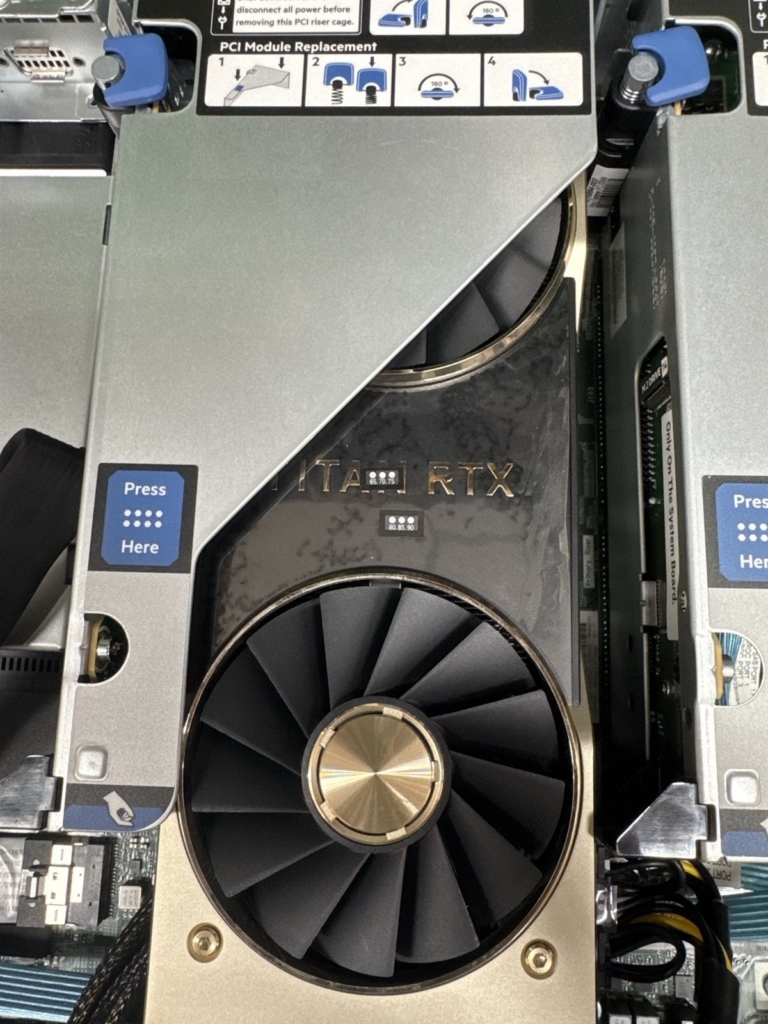
ラックサーバの HPE ProLiant DL385 Gen10 に NVIDIA TITAN RTX(24GB)を積んで、ローカル LLM の推論サーバにしました。
以前の記事では、Mac で動かしたローカル LLM がエージェントの処理に追いつきませんでした。今回は GPU を積んだ専用機を用意しています。
→ 【後編】Zabbix × Claude × LibreChat ─ モデル比較とハマったところ
前編はハードウェアの話です。GPU を積んで補助電源を取り、電力上限をいくつにするかを負荷試験で決めました。推論エンジンとモデルの比較は後編に書きます。
先に結論です。
- サーバ向けではない GPU でも、DL385 Gen10 のライザーから補助電源を取れば動きます。ただし iLO は GPU の温度を読めません
- 電力上限は 240W にしました。280W では GPU が 3 分で 84℃ に達し、熱によるクロック低下(スロットリング)が始まりました
- 限界を決めたのはケーブルではなく GPU 自身のファンでした。筐体ファンを 100% にしても、84℃ に達するまでの時間が 3 分から 5.5 分に延びただけです
構成
| 項目 | 内容 |
|---|---|
| サーバ | HPE ProLiant DL385 Gen10 |
| CPU / メモリ | AMD EPYC 7302(16 コア)× 2 / 512GB |
| GPU | NVIDIA TITAN RTX 24GB GDDR6(Turing / TU102、Compute Capability 7.5) |
| 電源 | 1600W × 2(冗長) |
| ストレージ | NVMe(OS とモデル置き場) |
| OS | Ubuntu Server 26.04.1 LTS |
| ドライバ | NVIDIA 595.91.07(open kernel module、CUDA 13.2) |
| 推論ランタイム | Ollama 0.40.6 |
TITAN RTX の電力上限は、既定が 280W で、nvidia-smi で 100〜320W の範囲に設定できます。
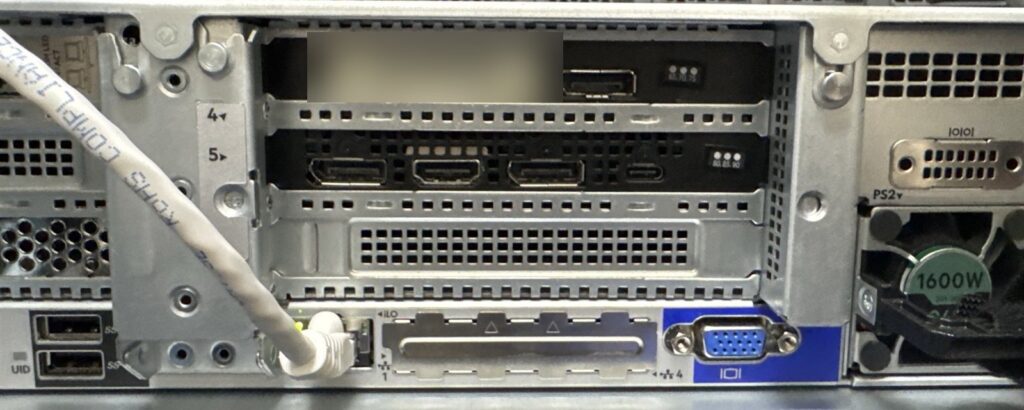
GPU を積む
補助電源はライザーから取る
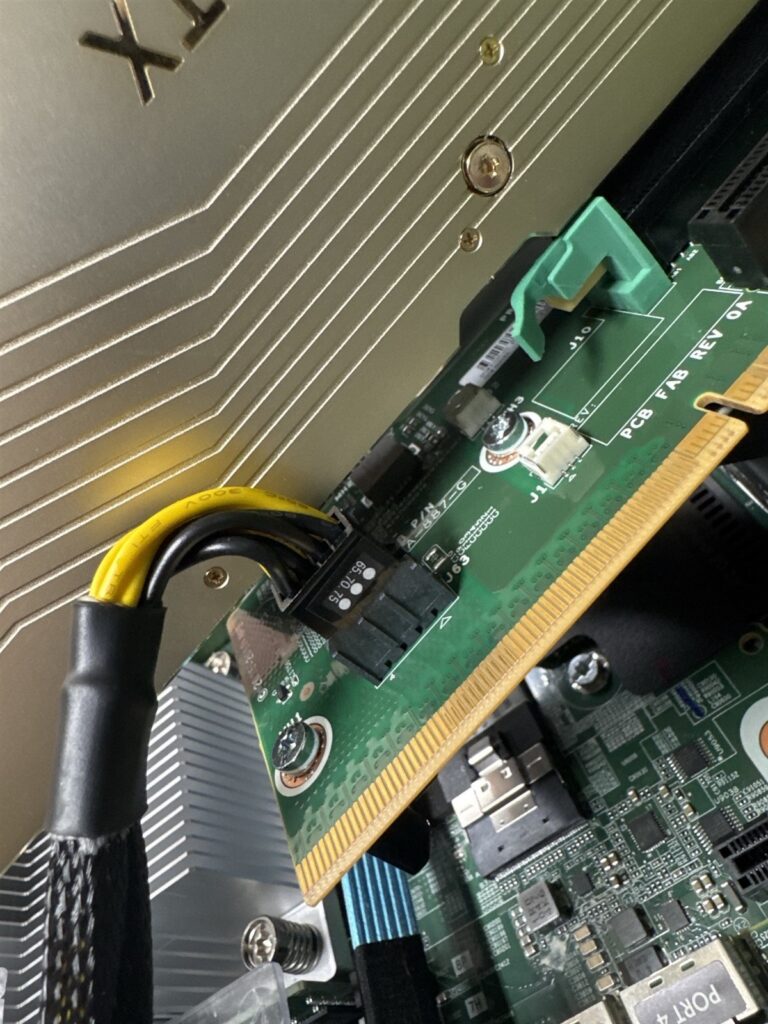
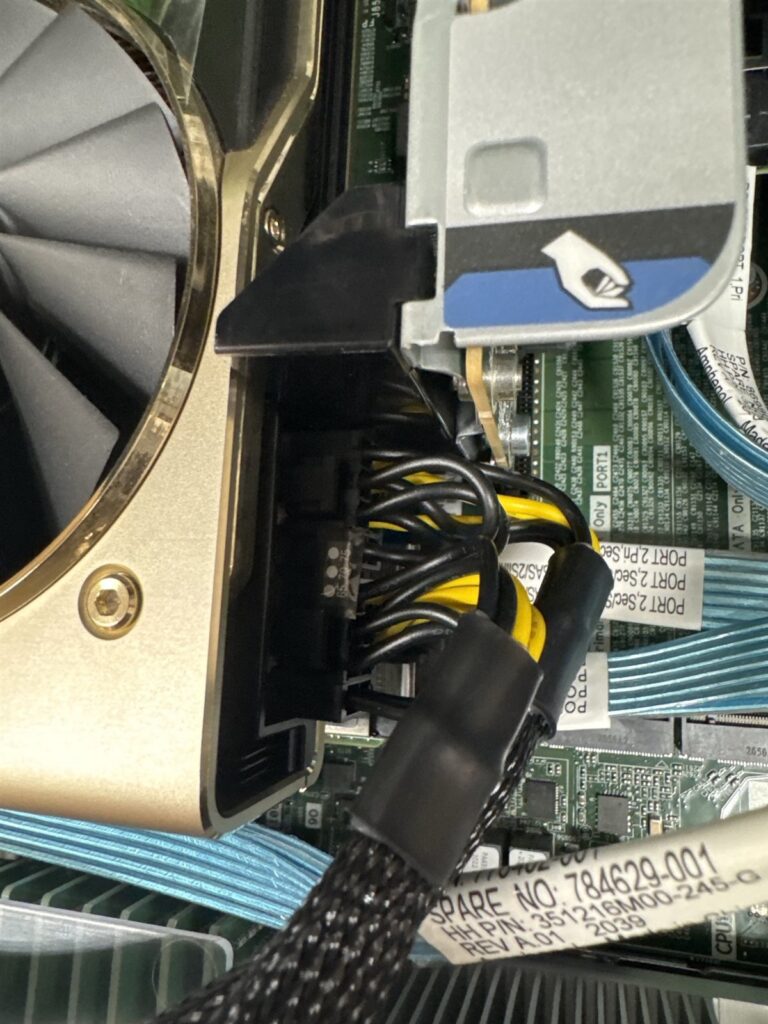
DL385 Gen10 のライザーには GPU 用の補助電源コネクタがあります。HPE 純正の構成では、GPU 用の Y ケーブル(871830-B21)でここから給電します。
HPE の QuickSpecs を見ると、TITAN RTX と同じ TU102 を積んだ Quadro RTX 6000 / 8000 が、このケーブルで正式にサポートされています。つまりコネクタ側は、300W 級の GPU を想定した設計です。
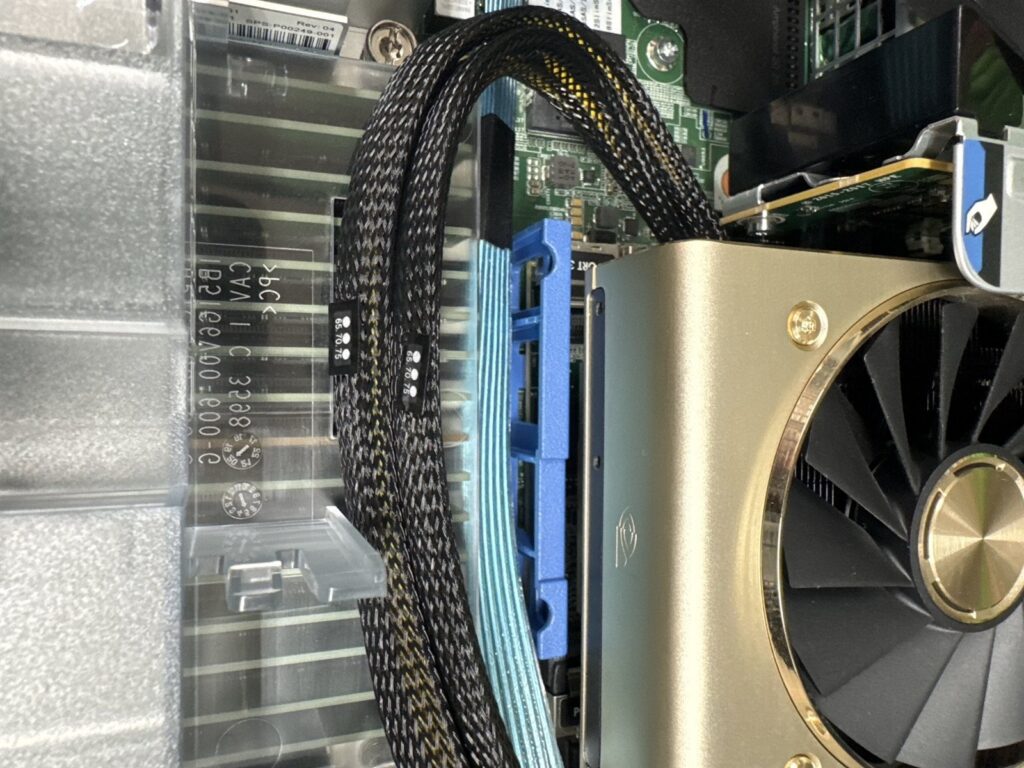
今回はサードパーティ製の変換ケーブルを使いました。ライザー側の 1 本を、GPU 側の 8 ピン(6+2)× 2 に分岐するものです。純正品ではないため、線材や圧着の品質までは分かりません。そこで、電力上限は 200W から始めて、試験で見極めることにしました。
iLO は GPU の温度を読めない
サーバ向けの GPU と違い、一般向けの GPU は iLO から温度が見えません。iLO は GPU の発熱に合わせてファンを上げてくれない、ということです。
そこで BIOS(RBSU)の Thermal Configuration を Increased Cooling にして、筐体ファンを常に強めに回しています。GPU の温度は OS 側から nvidia-smi で見ます。
ドライバと電力上限の設定
ドライバ
Ubuntu の ubuntu-drivers で、サーバ向け(GPGPU 用)のドライバを入れました。
sudo ubuntu-drivers install --gpgpu
# → nvidia-headless-no-dkms-595-server-open が入る
sudo apt install nvidia-utils-595-server   # nvidia-smi は別パッケージ
電力上限は再起動で戻る
nvidia-smi -pl で設定した電力上限は、再起動すると既定の 280W に戻ります。そこで、起動時に設定する systemd のユニットを作りました。
# /etc/systemd/system/nvidia-power-limit.service
[Unit]
Description=Set NVIDIA GPU persistence mode and power limit
Wants=nvidia-persistenced.service
After=nvidia-persistenced.service

[Service]
Type=oneshot
RemainAfterExit=yes
# GPU が見えるまで最大 30 秒待つ
ExecStartPre=/bin/sh -c 'for i in $(seq 30); do nvidia-smi -L >/dev/null 2>&1 && exit 0; sleep 1; done; exit 1'
ExecStart=/usr/bin/nvidia-smi -pm 1
ExecStart=/usr/bin/nvidia-smi -pl 240
Restart=on-failure
RestartSec=5

[Install]
WantedBy=multi-user.target
Ollama 側は、このユニットに依存させています。
# /etc/systemd/system/ollama.service.d/override.conf(抜粋)
[Unit]
Requires=nvidia-power-limit.service
After=nvidia-power-limit.service

[Service]
ExecStartPre=/usr/bin/nvidia-smi -L
狙いは 2 つです。
- 電力上限がかかる前に推論が始まらないようにする
- GPU が見えないときは Ollama を起動させない。Ollama は GPU が無くても CPU で動いてしまうので、気づかないまま極端に遅い状態で動き続けるのを防ぎます
起動時のジャーナルには、次のように出ます。
Power limit for GPU 00000000:C3:00.0 was set to 240.00 W from 280.00 W.注意点として、systemctl restart nvidia-power-limit を実行すると、依存している Ollama も再起動します。運用中に上限を変えるときは nvidia-smi -pl を直接使います。
カーネルとドライバを固定する
ドライバのカーネルモジュール(linux-modules-nvidia-595-server-open-*)は、新しいカーネルに追随するとは限りません。自動更新でカーネルだけ上がると、次の再起動で GPU が見えなくなるおそれがあります。
そこで、カーネルと NVIDIA 595 系のパッケージを apt-mark hold で止め、月に 1 回、手動で更新しています。更新したら、新しいカーネルで nvidia-smi が通ることを確かめてから古いカーネルを消します。
電力上限をいくつにするか
200W でも上限に張り付いていた
まず 200W のまま 15 分の負荷をかけたところ、負荷時間の 95.6% で電力上限に当たっていました。GPU は電力が足りずにクロックを落としている状態で、上限を上げれば速くなる余地があります。
試す上限は 200 → 240 → 280W としました。280W は TITAN RTX の既定値で、Quadro RTX 6000 / 8000 の 300W 級の範囲にも収まります。最大の 320W は試していません。
なお、電力上限は平均値で抑える仕組みです。200W に設定していても、瞬間的には 240W 前後まで出ていました。
試験のやり方
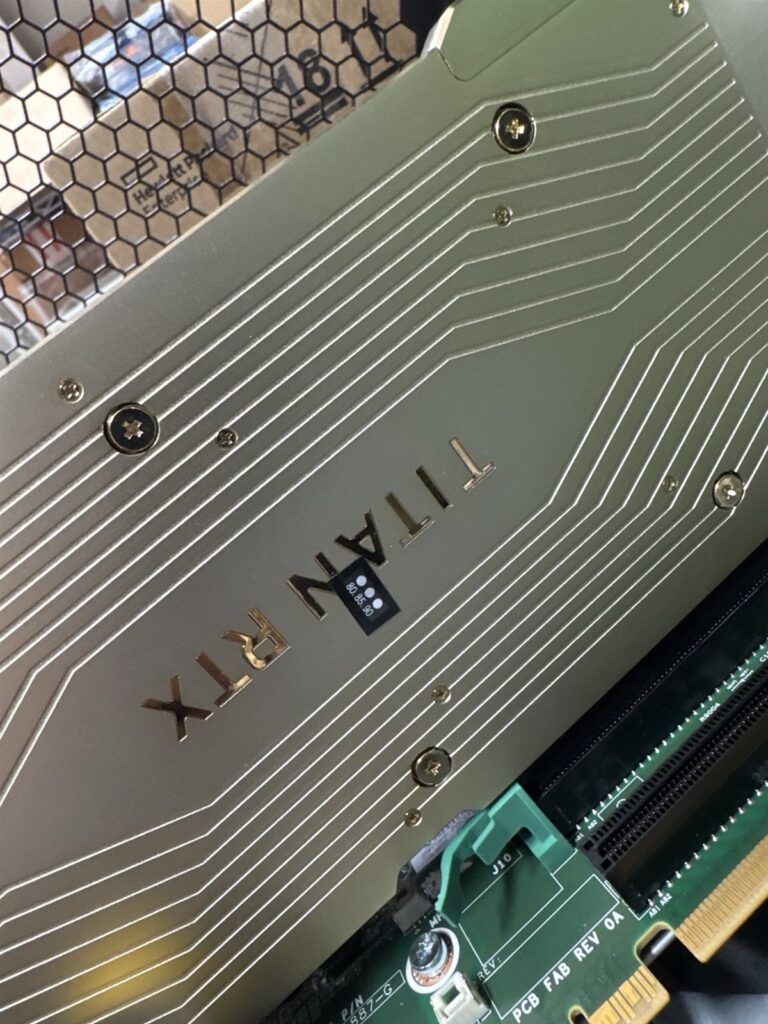
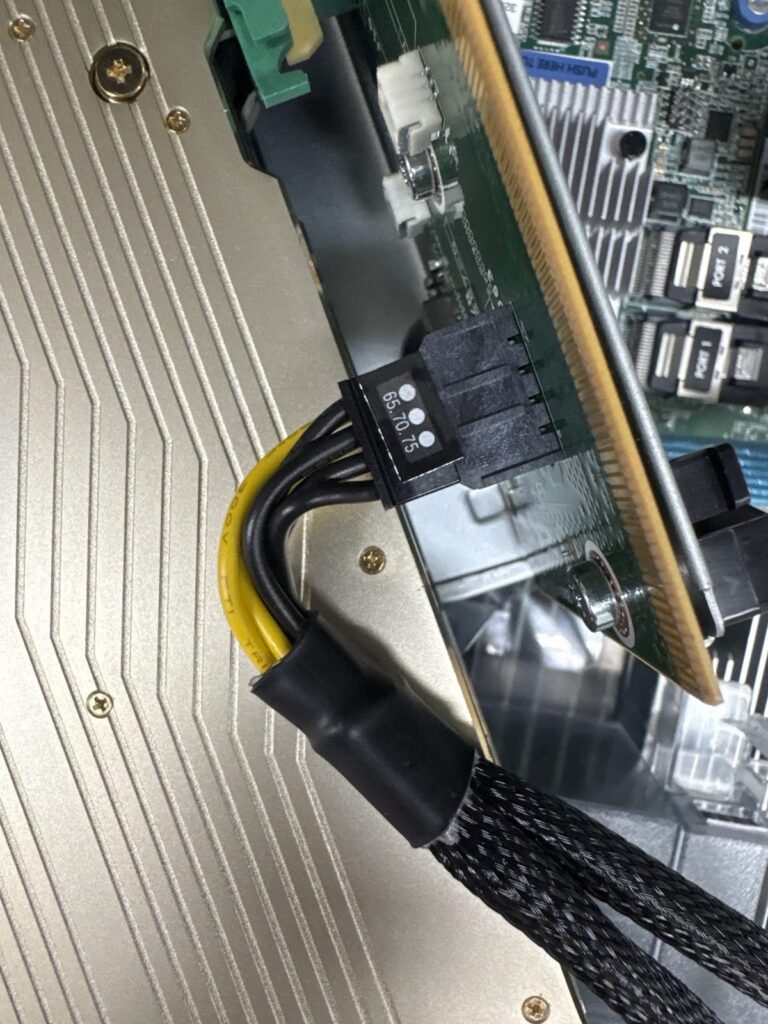
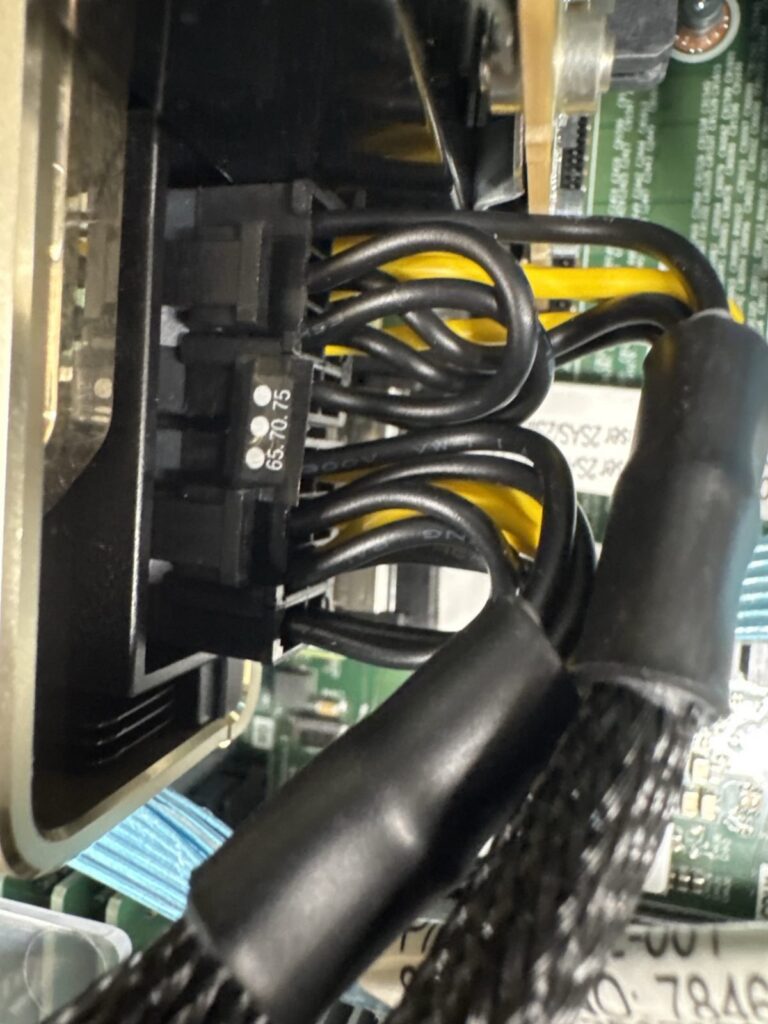
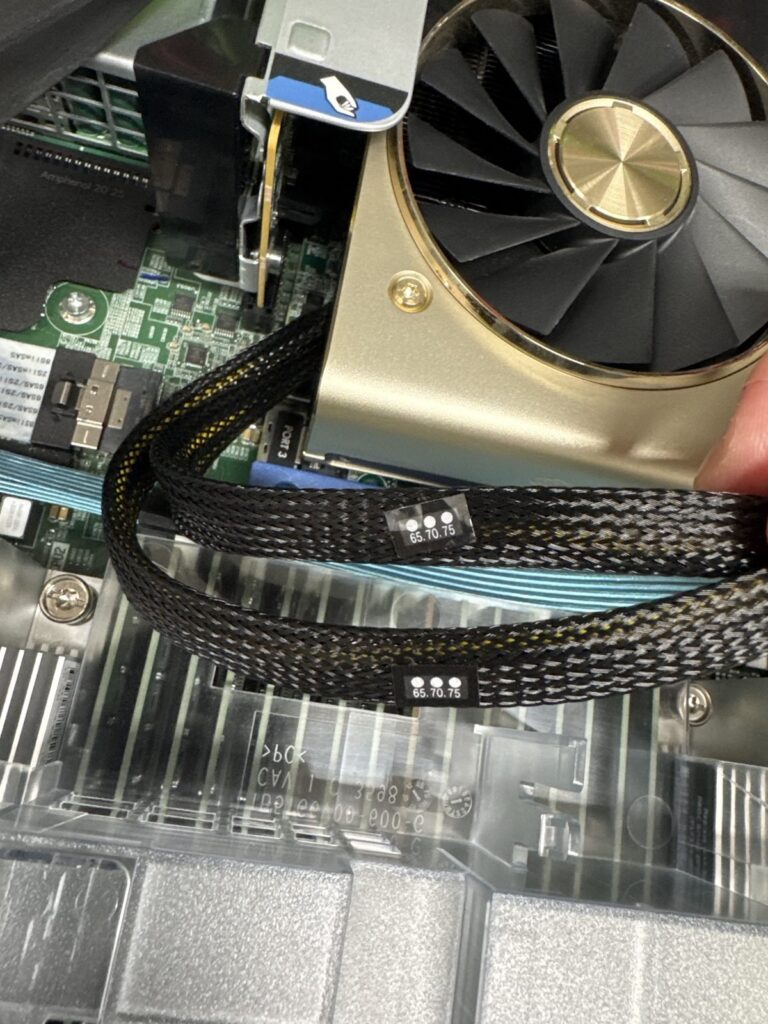
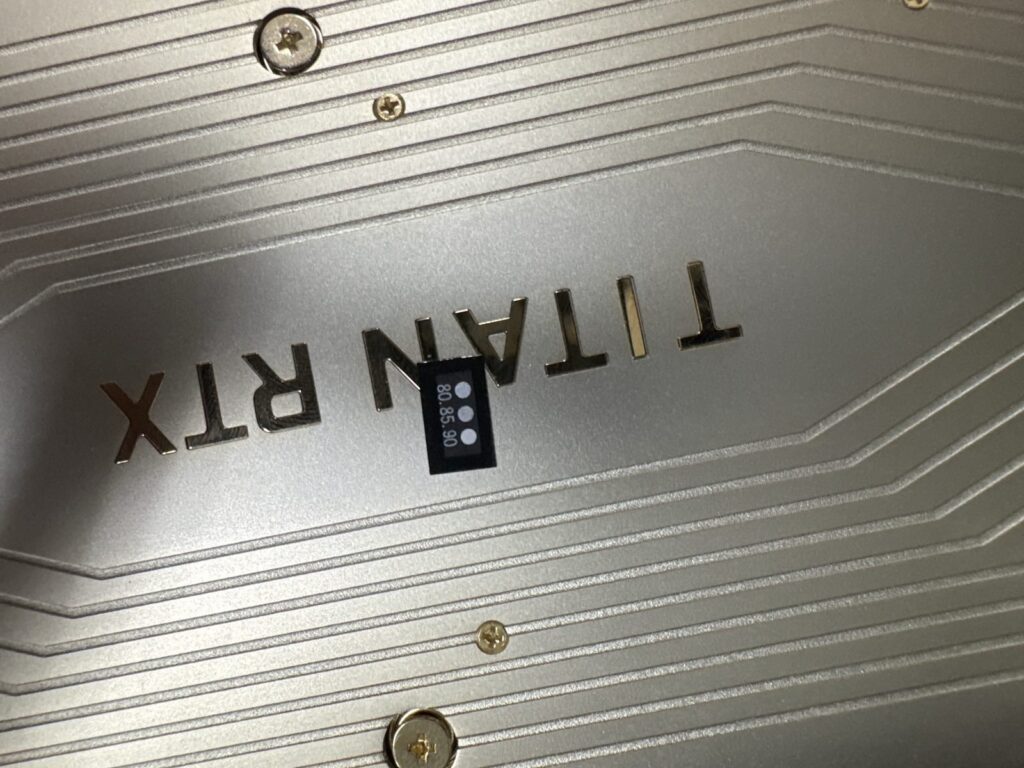
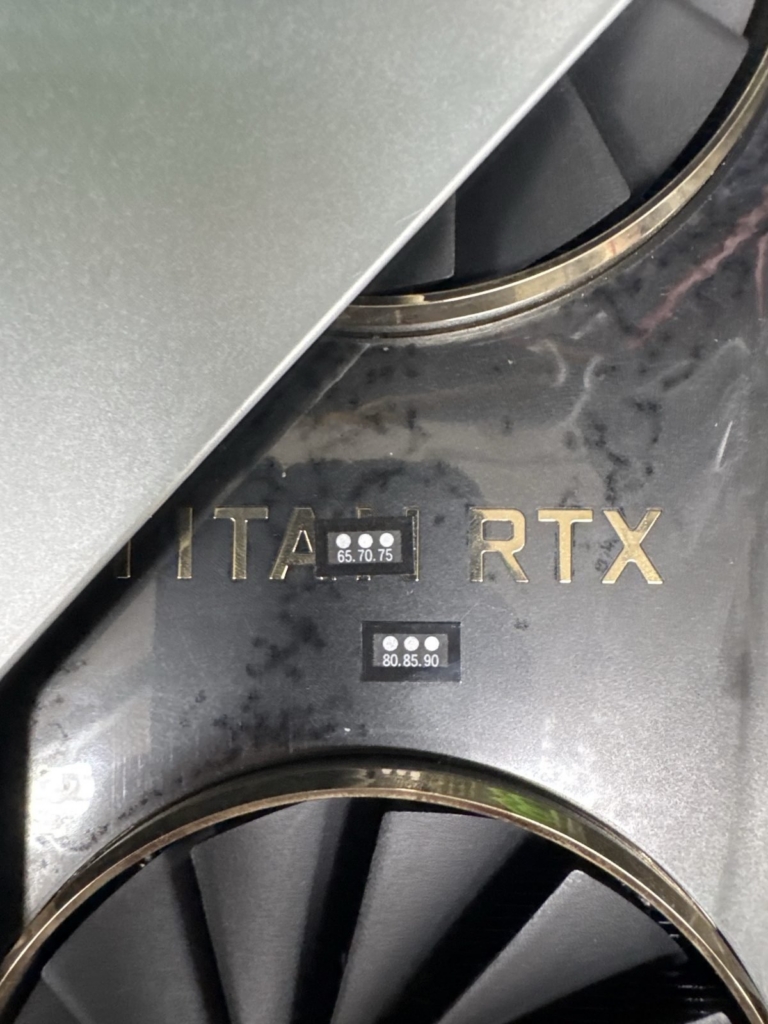
ケーブルの発熱はソフトウェアからは読めません。そこで、不可逆のサーモラベル(一度変色すると元に戻らない温度シール)を 7 か所に貼りました。
| 貼った場所 | ラベル | 使い方 |
|---|---|---|
| ライザー側コネクタ | 65 / 70 / 75℃ | 65℃ で変色したら中止 |
| GPU 側プラグ | 65 / 70 / 75℃ | 65℃ で変色したら中止 |
| ケーブル(2 本) | 65 / 70 / 75℃ | スリーブ越しなので参考値 |
| GPU バックプレート | 80 / 85 / 90℃ | 記録用 |
| ファン側シュラウド | 65〜90℃ | 表面温度の参考 |
| 背面ブラケット | 65〜90℃ | 蓋を開けずに確認できる唯一の場所 |
各段の進め方は次のとおりです。
- 20 分以上の連続負荷をかけ、直近 5 分の温度上昇が 1℃ 未満になったら熱平衡とみなす
- 上限の 95% 以上の電力を累計 5 分以上使えていれば、その段の結果を有効とする
- 次のどれかが起きたら、監視スクリプト(1 秒間隔)が負荷を止めて 200W に戻す: GPU 85℃、スロットリング、Xid エラー、PCIe のリンク低下
- 人が立ち会い、15 分ごとに操作しないと負荷が止まる仕組み(デッドマン)にする。ケーブルの発煙のような異常は人の目でしか拾えないため
監視スクリプトが見ている値は次のとおりです。
nvidia-smi --query-gpu=temperature.gpu,power.limit,pcie.link.gen.current,pcie.link.width.current,utilization.gpu,clocks_event_reasons.sw_thermal_slowdown,clocks_event_reasons.hw_thermal_slowdown,clocks_event_reasons.hw_power_brake_slowdown,clocks_event_reasons.hw_slowdown --format=csv,noheader,nounits結果
| 上限 | 消費電力(中央値 / 最大) | 平衡温度 | GPU ファン | SM クロック | prefill(tok/s) | 生成(tok/s) | 判定 |
|---|---|---|---|---|---|---|---|
| 200W | 196 / 240W | 74℃ | 57% | 1,530MHz | 2,633 | 94.6 | 合格 |
| 240W | 236 / 269W | 80℃ | 58〜61% | 1,605〜1,665MHz | 2,884 | 97.4 | 合格 → 採用 |
| 260W(追加) | 256 / 293W | 81℃ | 59〜63% | 1,695〜1,725MHz | 2,992 | 100.7 | 合格だが不採用 |
| 280W | 277 / 289W | 3 分で 84℃ | 62〜63% | 1,770MHz | ─ | ─ | 不合格 |
prefill と生成の速度は gpt-oss:20b で測りました。260W だけは、筐体ファンを 100% にした条件(Maximum Cooling)での値です。どの段でも Xid エラーは 0 で、PCIe も Gen3 x16 のまま落ちませんでした。
280W は GPU の熱で止まった
280W では、負荷をかけてから 3 分で GPU が 84℃ に達しました。84℃ はドライバの目標温度(Target)で、ここに達すると sw_thermal_slowdown が立ってクロックが下がります。監視スクリプトが中止条件に当たったと判断し、負荷を止めました。
筐体の風量が足りないのかと考えて、Thermal Configuration を Maximum Cooling(筐体ファン 6 基すべて 100%)に変えて試し直しました。しかし、84℃ に達するまでの時間が 3 分から 5.5 分に延びただけでした。
このとき GPU 自身のファンは 63% までしか回っていませんでした。 TITAN RTX のファンは静音寄りの設定で、目標温度に達するまで回転を上げ切りません。限界を決めていたのは筐体の風量ではなく、GPU 自身のファンでした。
サーバ向けの GPU の多くはファンを持たず(パッシブ冷却)、筐体ファンの風で冷やす前提で作られています。TITAN RTX は自前の 2 連ファンで冷やすので、筐体ファンを上げても効きが限られます。ファンを強制的に回す設定(Coolbits)を入れれば 280W も通るかもしれませんが、構成が複雑になるのでやめました。
260W も試したが、効果が小さかった
240W と 280W の間を埋めるため、260W も追加で試しました。熱平衡は 81℃ で通りましたが、240W からの伸びは prefill で 1〜4% だけです。しかも筐体ファン 100% が前提で、騒音が大きくなります。
採用値は 240W にしました。200W と比べて、prefill は 5〜10%、dense モデルの生成は 13% 速くなります。MoE モデルの生成速度はほぼ変わりません。
ケーブルは発熱しなかった
全段を終えたあと、蓋を開けてラベルを確認しました。7 か所すべて、どの温度でも変色していませんでした。サードパーティ製ケーブルは、瞬間 293W・連続 260W までコネクタにも線材にも発熱の兆候なし、という結果です。
まとめ
- DL385 Gen10 は、ライザーの補助電源コネクタから 300W 級の GPU に給電できる設計です。サードパーティ製ケーブルでも、サーモラベルで確かめながら段階的に上げれば見極められます
- 一般向けの GPU は iLO から温度が見えません。BIOS で筐体ファンを強めにし、温度は
nvidia-smiで見ます - 電力上限は systemd で起動時に設定し、推論ランタイムをそれに依存させると、GPU が見えないまま動き続ける事故を防げます
- TITAN RTX の電力上限を決めたのは、ケーブルではなく GPU 自身のファンでした。このサーバでは 240W が落としどころです
後編では、この GPU で推論エンジン 4 種(Ollama / llama-server / vLLM / SGLang)と 17 のモデルを比べた結果を書きます。