【前編】Zabbix × Claude(Amazon Bedrock)× LibreChat で、ネットワーク障害の一次切り分けを AI に任せてみた ─ 構成と仕組み
はじめに
Zabbix が障害を検知したら、AI が自分でネットワーク機器にログインして config とログを調べ、切り分けた結果を報告してくれる仕組みを作ってみました。
人がやっていた一次切り分け ─ 「Zabbix を見る → 機器に入る → config とログを見る → 原因を推定する → 報告を書く」─ を自動化したもので、障害の検知から平均 2 分で報告が届きます。
ポイントは次の 2 つです。
- AI は「提案」までしかしない。 復旧の操作は一切実行させません(読み取り専用を徹底)
- 待機中のコストはゼロ。 60 秒ごとに Zabbix を見るだけで、LLM は障害を検知したときにしか動きません
記事は前後編に分けました。
- 前編(この記事): なぜ作ったか、全体の構成、各部品の役割、実際の動作
- 後編: 7 つのモデルで比べた結果、ハマったところ、コストと限界
なぜ作ったか
一次切り分けは「手順はほぼ決まっているのに、人がやると時間がかかる」典型的な作業です。
| いつもの作業 | 困るところ |
|---|---|
| Zabbix のアラートを見る | 分かるのは症状だけ。原因は機器の中にある |
| 機器にログインして config とログを見る | 機器ごとにコマンドが違う(Junos / IOS) |
| 波及した障害を切り分ける | 原因 1 つでアラートが 10 件、20 件と出る。因果を人が整理する |
| 報告を書く | 深夜や休日でも同じ品質が求められる |
特にやっかいなのが、「人がポートを落としたのか、本当に壊れたのか」の見分けです。
Zabbix の Link down は ifOperStatus しか見ていないので、人が disable してもケーブルが抜けても、まったく同じアラートになります。機器の config とログを見ないと区別できません。ここを AI に見に行かせたい、というのが出発点です。
検証環境
ネットワークは次の 6 台で組んでいます。
| 機器 | 台数 | OS | 役割 |
|---|---|---|---|
| Juniper QFX5120-48Y-8C | 4 | Junos | 2 台ずつ 2 つの AS(AS65001 / AS65002)。AS 内は LAG(ae0)上の iBGP、AS 間は eBGP。BFD で断を早く検知 |
| Cisco C891FJ-K | 2 | IOS 15.8(3)M9 | VRRP の仮想 IP を下流のデフォルトゲートウェイにする。BGP には参加しない |
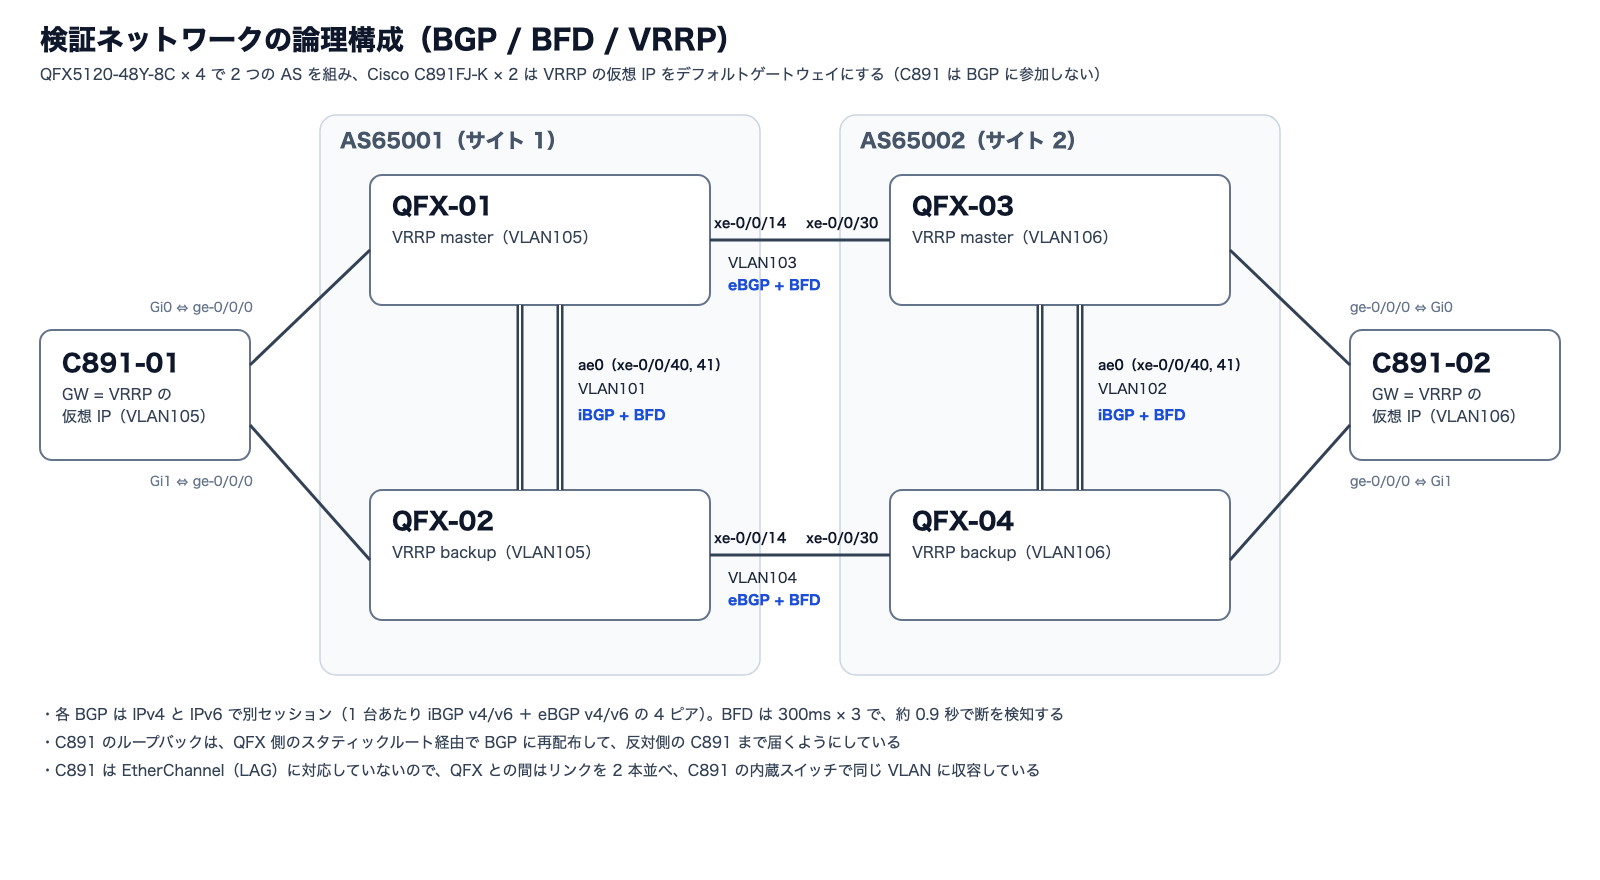
周りのサーバは ESXi 上の Ubuntu で、Zabbix 7.4(監視)・NetBox 4.5(構成台帳)・Ansible(機器の操作)が動いています。今回の仕組みは、ここに AI の層を足したものです。
全体構成
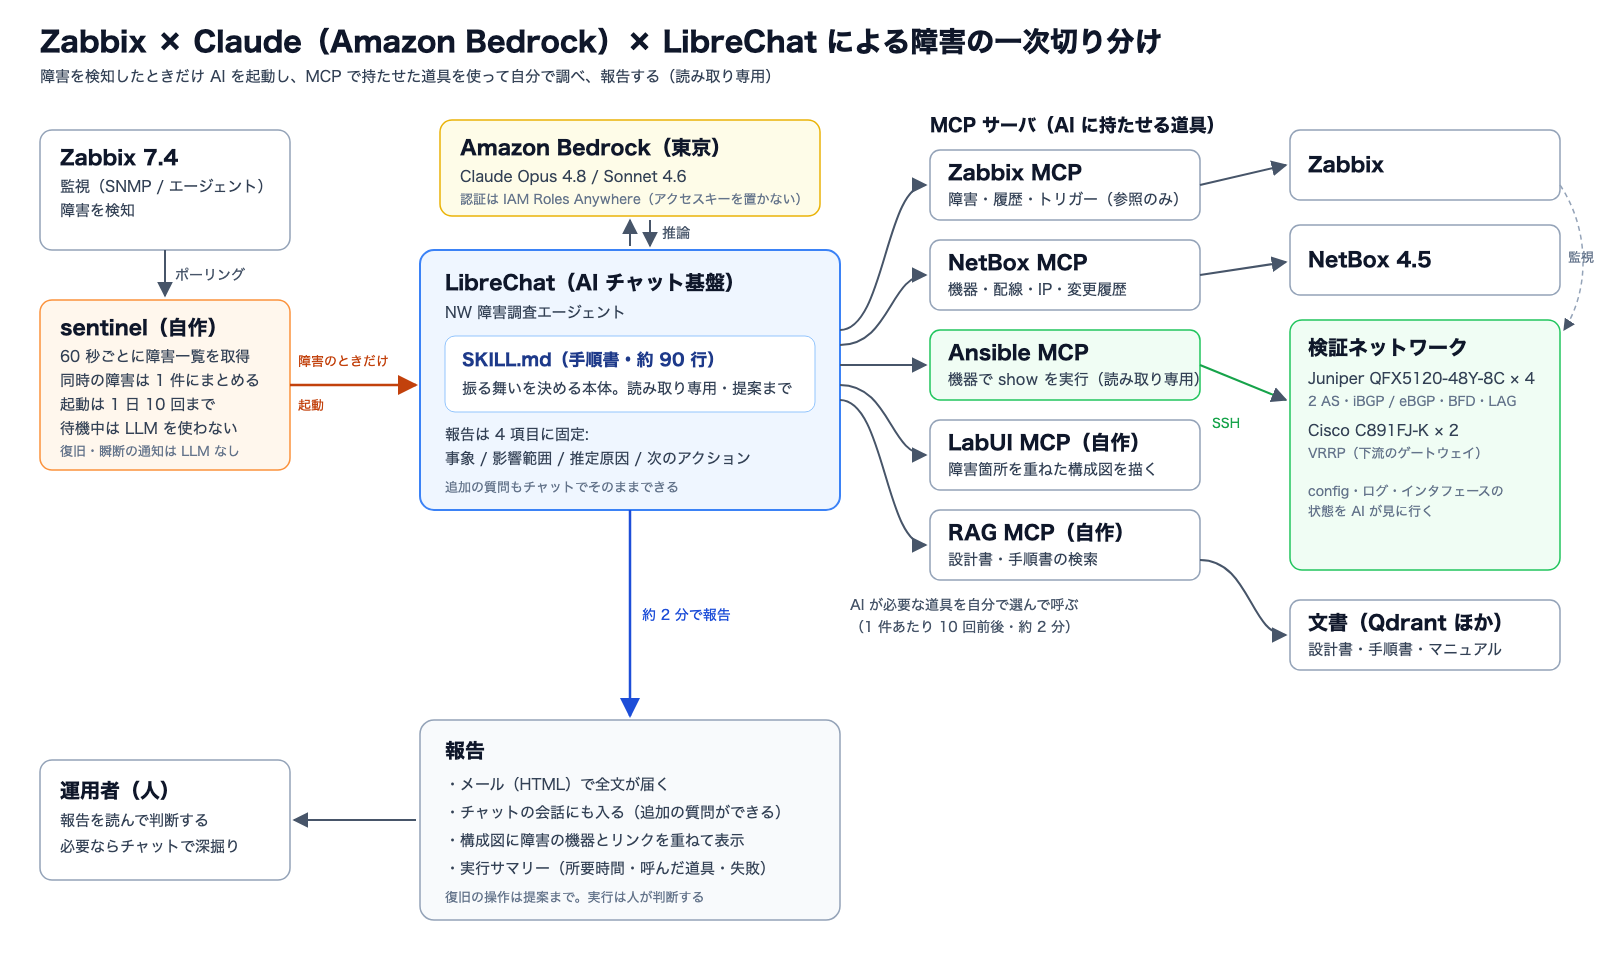
主役は次の 4 つです。
| 部品 | 役割 |
|---|---|
| LibreChat | オープンソースの AI チャット基盤。エージェント(AI が自分で道具を選んで使う仕組み)と MCP に対応している。今回の司令塔 |
| Amazon Bedrock(東京リージョン) | LLM の実行基盤。Claude Opus 4.8 / Sonnet 4.6 を使う |
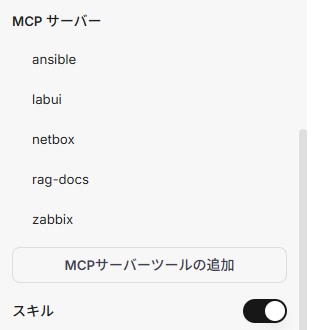
| MCP サーバ × 5 | AI に持たせる「道具」。Zabbix・NetBox・Ansible・構成図・文書検索 |
| sentinel(自作) | Zabbix を見張り、障害を検知したときだけエージェントを起動する常駐プログラム |
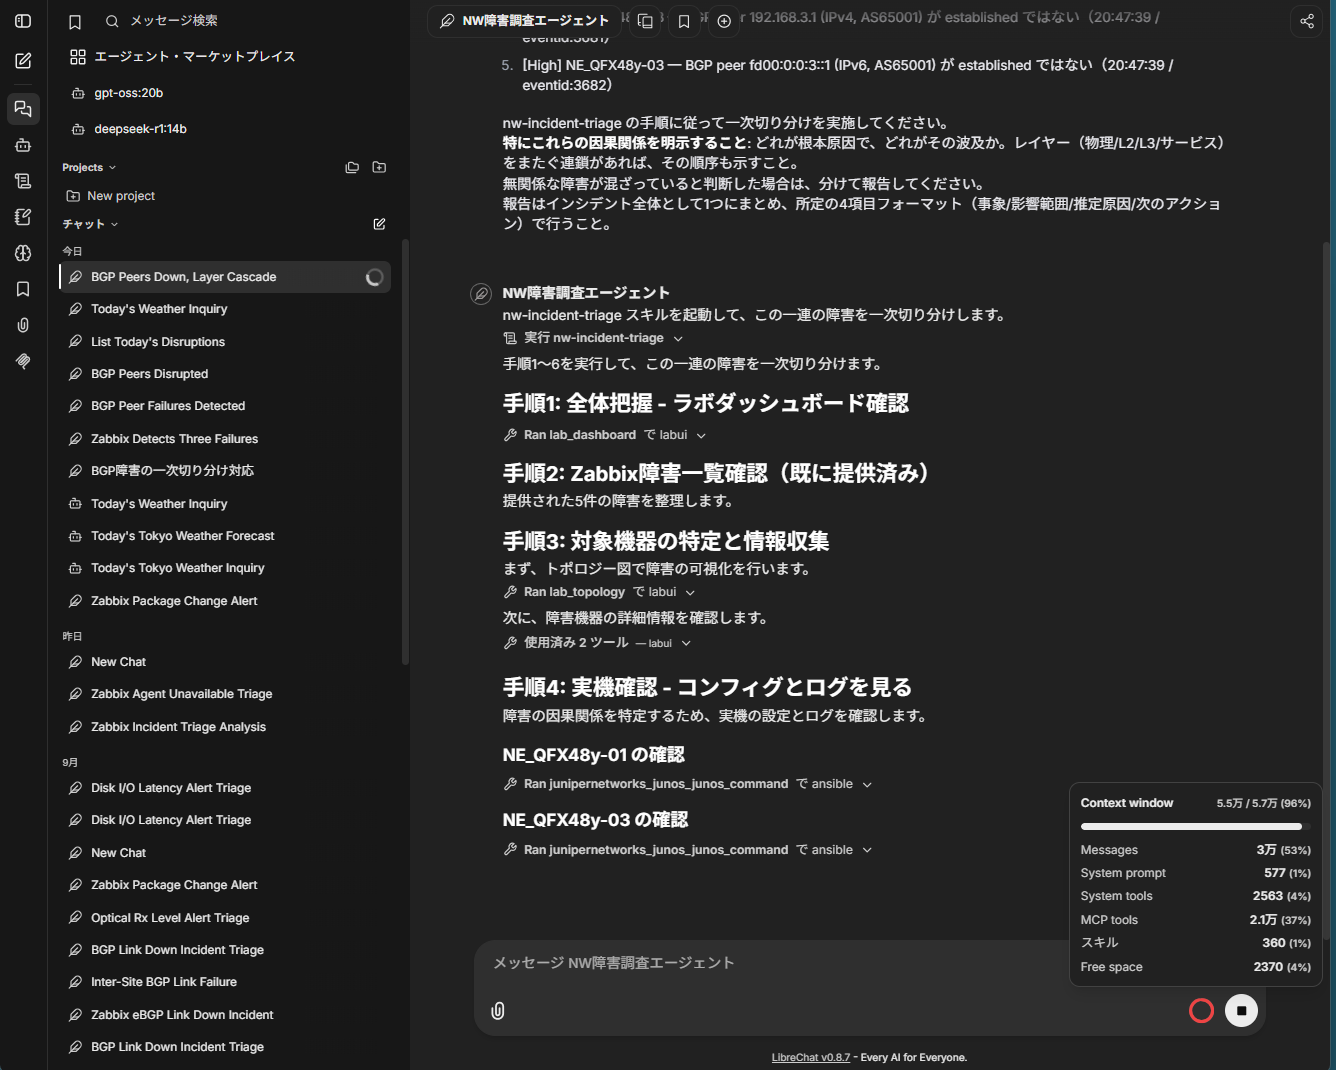
LibreChat の画面はこんな見た目です。左が会話の一覧、右が障害の調査をしている会話で、ChatGPT などと同じ感覚で使えます。sentinel が起動した調査も、この一覧に会話として残ります。
MCP とは
MCP(Model Context Protocol)は、AI に「道具」を持たせるための共通の規格です。
道具を MCP サーバとして用意しておくと、AI は「いま必要なのは Zabbix の障害一覧だ」「次はこの機器の show interfaces を見よう」と自分で判断して呼び出します。人が手順をプログラムで組むのではなく、AI が調べる順番を組み立てるのが、普通のスクリプトとの違いです。
今回つないだのは次の 5 つです。
| MCP | 役割 | 例 |
|---|---|---|
| Zabbix MCP | 監視の「今の値」 | 障害一覧・履歴・トリガーの定義 |
| NetBox MCP | 構成の「台帳」 | 機器・配線・IP アドレス・変更履歴 |
| Ansible MCP | 機器でコマンドを実行(読み取り専用) | show interfaces extensive、show log messages など |
| LabUI MCP(自作) | チャットの中に図を描く | 障害箇所を重ねた構成図 |
| RAG MCP(自作) | 設計書・手順書の検索 | 「なぜこの構成なのか」 |
Ansible の MCP は読み取り系のモジュールだけを許可しています。AI が設定を変えることは、仕組みとしてできません。
LibreChat のエージェントの設定画面では、この 5 つの MCP サーバとスキル(後述)を有効にしているだけです。
Bedrock への認証は IAM Roles Anywhere で
LibreChat は ESXi 上の VM(オンプレミス)で動いているので、Bedrock を呼ぶには AWS の資格情報が要ります。アクセスキーを VM に置くのは避けたかったので、IAM Roles Anywhere を使いました。
自前の CA で発行した証明書を使って、一時的な資格情報を取得する方式です。ロールに付けた権限は bedrock:InvokeModel だけで、対象のモデルとリージョンにも絞っています。追加の費用はかかりません。
ひとつハマったのは、AWS 公式の aws_signing_helper が glibc 向けのバイナリで、Alpine(musl)ベースの LibreChat のコンテナでは動かないことでした。そこで次のようにしました。
- ホスト側で
aws_signing_helper serveを常駐させる(EC2 のメタデータサービス = IMDS を模擬してくれる) - コンテナには
AWS_EC2_METADATA_SERVICE_ENDPOINTでそこを指させる - AWS SDK の既定の手順(資格情報チェーン)が、IMDS から一時的な資格情報を取ってくる
証明書も秘密鍵もコンテナの中に入れずに済むので、結果的にこちらのほうが安全な構成になりました。
振る舞いを決めているのは「手順書」1 枚
ここがいちばん面白かったところです。
LibreChat の「NW 障害調査エージェント」の定義を見ると、システムプロンプトは空で、サブエージェントも使っていません。代わりに SKILL.md という Markdown の手順書(約 90 行)を読み込ませています(Claude Code のスキルと同じ形式です)。
手順の骨格はこうなっています。
1. 全体把握      LabUI    ラボの主要サービスの死活
2. 障害一覧      Zabbix   重要度順に整理
3. 機器の特定    LabUI    + NetBox で配線や変更履歴を補足
4. 実機確認      Ansible  config とログ(読み取り系コマンドのみ)
5. 視覚化        LabUI    影響範囲を構成図で
報告は 「事象 / 影響範囲 / 推定原因 / 次のアクション」の 4 項目に固定し、「復旧の操作は提案までで実行しない」を禁止事項として書いています。
つまり、「障害を検知 → 調べて報告する」という一連の動きを生んでいるのは、コードでもプロンプトでもなく、この Markdown に書かれた手順です。挙動を変えたければ手順書を直します。そして後編で書きますが、手順書に書いていないことを AI は本当にやりません。
sentinel:障害を検知したときだけ AI を起こす
sentinel は Python で書いた小さな常駐プログラム(systemd のサービス)です。
| やること | LLM を使うか |
|---|---|
| 60 秒ごとに Zabbix の障害一覧を取得 | 使わない |
| 新しい障害を見つけたら、エージェントを起動して調査させる | 使う |
| 復旧したら通知する(継続時間つき) | 使わない(推論が要らない) |
| 一瞬で戻った障害(瞬断)を通知する | 使わない |
| 何度も繰り返す瞬断(フラッピング)を調査させる | 使う |
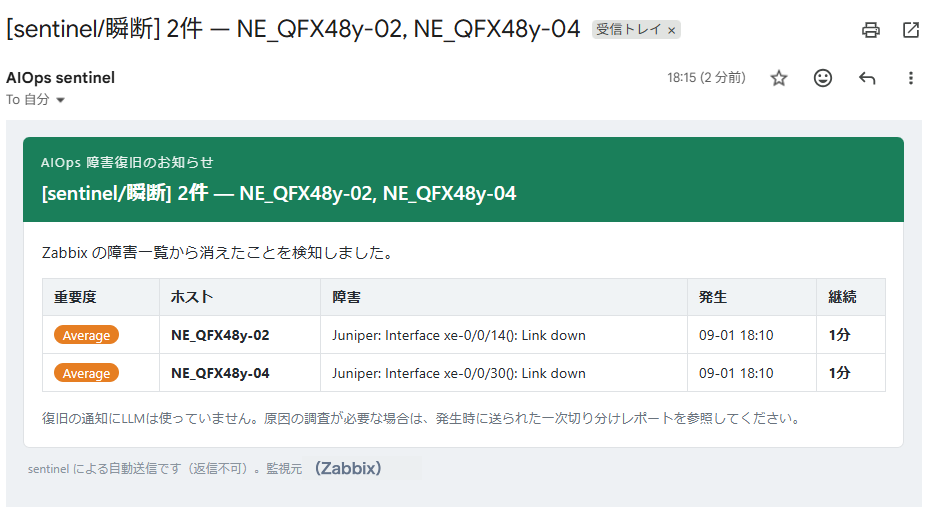
復旧の通知はこんな形です。障害の一覧から消えたことを検知して、継続時間を添えて知らせるだけなので、LLM は使っていません。
作ってみて大事だと分かった設計が 3 つあります。
1. 同時に出た障害は 1 つのインシデントとしてまとめて渡す
原因 1 つで 10 件、20 件の障害が出るのはよくあることです。個別に調査させると、
- 同じ原因を件数分だけ調べて、時間とコストを無駄にする
- レイヤーをまたぐ因果(L1 のリンク断 → L3 の経路断)が見えなくなる
ので、1 回のポーリングで拾った障害はまとめて 1 回だけエージェントに渡し、「どれが根本原因で、どれが波及か」を答えさせています。
2. 1 日の起動回数に上限を付ける
フラッピングが続くと Bedrock を延々と呼び続けてしまうので、既定で 1 日 10 回までにしています。上限に達したら、検知の記録だけ残して AI は起動しません。
3. 復旧は「一覧から消えたもの」で検知する
Zabbix の problem.get は未解決の障害しか返しません。復旧すると一覧から消えるだけなので、増えたものだけ見ていると復旧に永久に気づけません。前回の一覧との差分を取って、消えたものを復旧として扱っています。
実際に動かしてみた
起こした障害
QFX-01 のポート xe-0/0/14 を、わざと disable にしてみました。Zabbix には 5 件のアラートが同時に上がります。
1. [High]    QFX-01 — BGP peer (IPv4) が established ではない
2. [High]    QFX-01 — BGP peer (IPv6) が established ではない
3. [High]    QFX-03 — BGP peer (IPv4) が established ではない
4. [High]    QFX-03 — BGP peer (IPv6) が established ではない
5. [Average] QFX-03 — Interface xe-0/0/30 Link down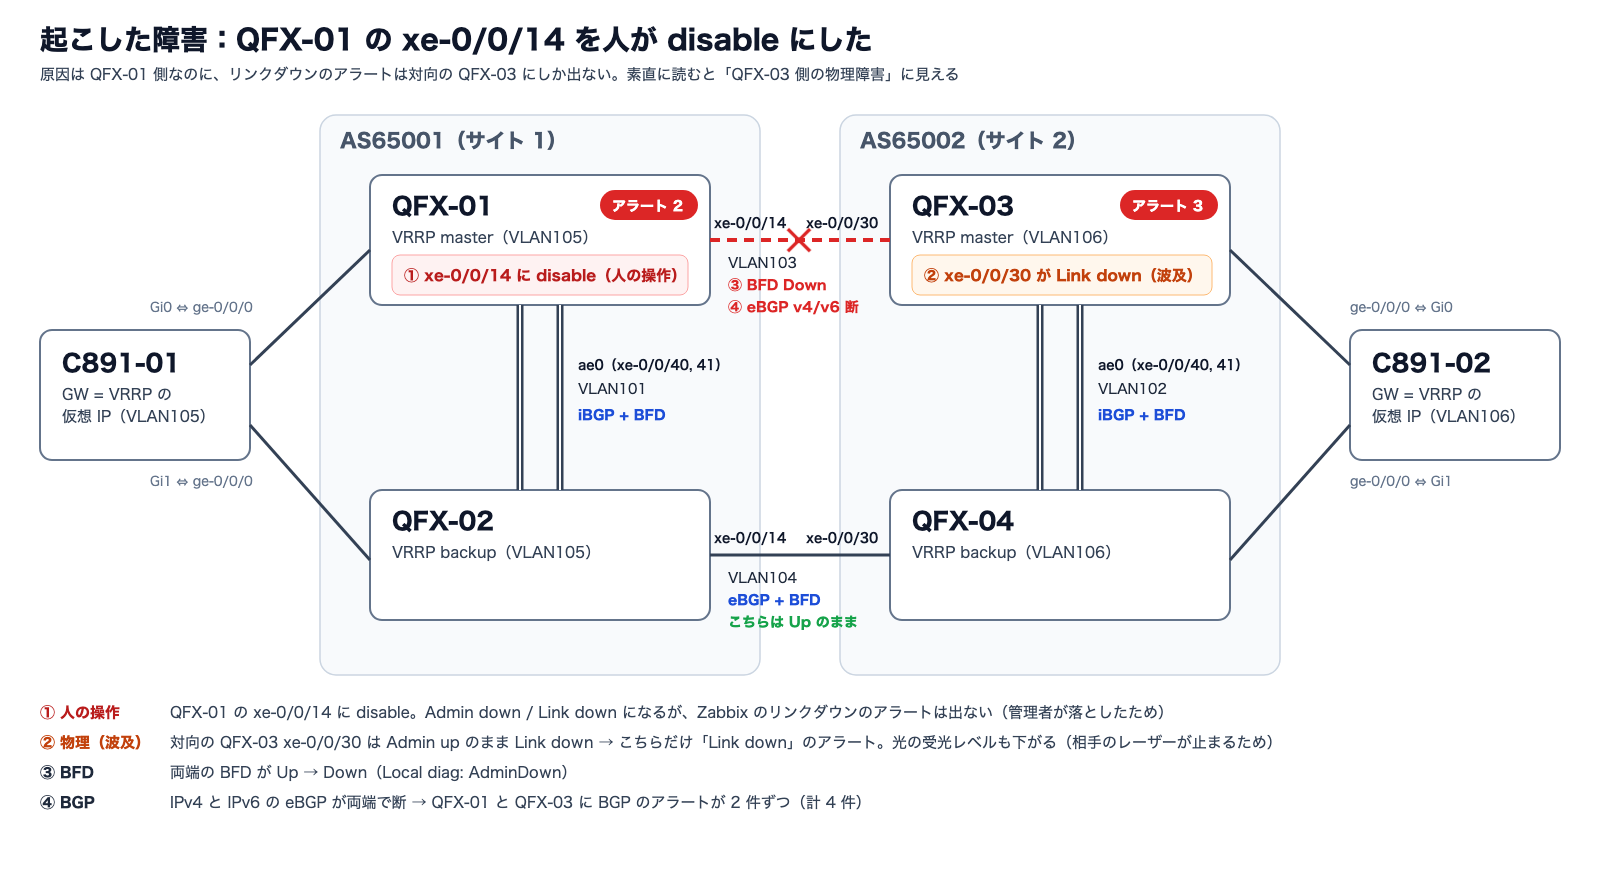
注目してほしいのは、原因のある QFX-01 はリンクダウンのアラートを出していないことです。落ちて見えるのは対向の QFX-03 だけなので、素直に読むと「QFX-03 側の物理障害」に見えます。
LibreChat の画面
sentinel が障害を検知すると、LibreChat に次のような会話ができます。上が sentinel から送った依頼(「因果関係を明示すること」「無関係な障害は分けて報告すること」など)で、その下でエージェントが手順書(nw-incident-triage)を読み込み、LabUI → Zabbix → Ansible の順に道具を呼んでいます。
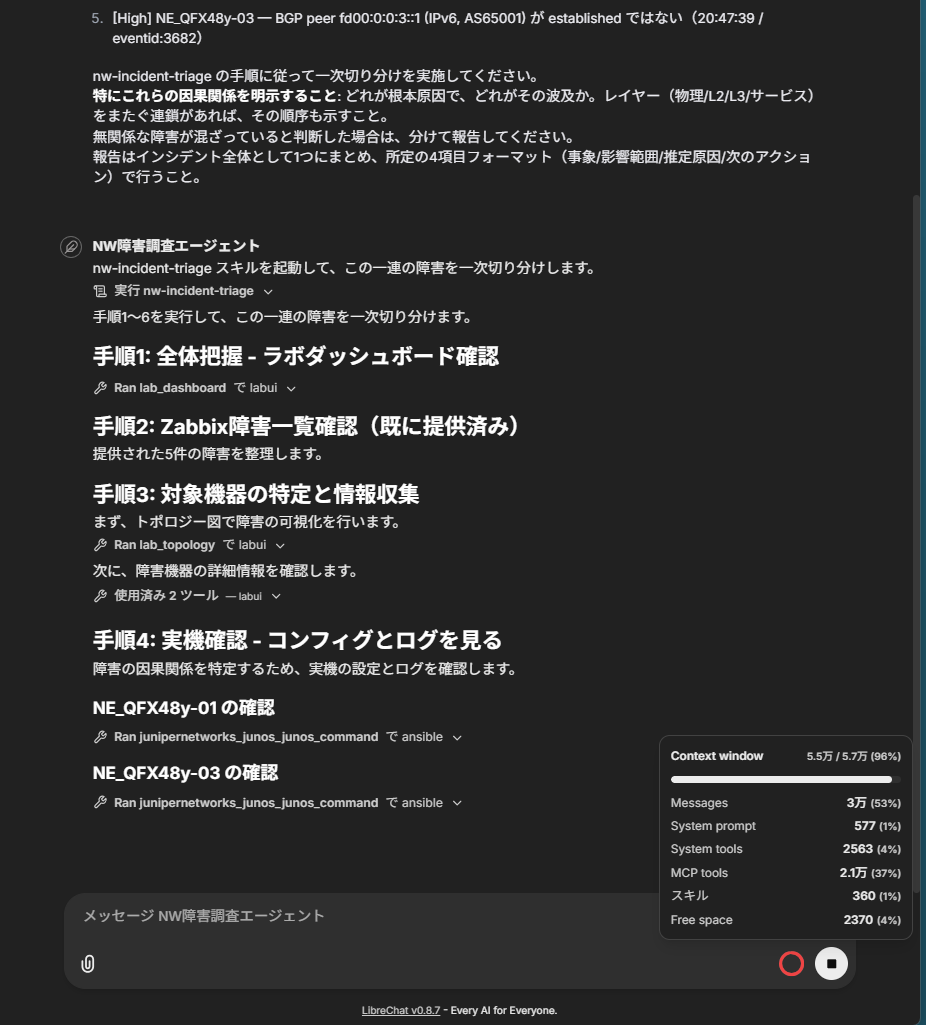
右下は文脈(コンテキスト)の使用量です。このときは 96% まで埋まっていました。この話は後編で書きます。
AI の結論
約 2 分で、次のような報告が届きました(要約)。
根本原因: QFX-01 の xe-0/0/14 を管理者が disable にした(物理故障ではない)

  01:05:00  admin が SSH でログイン
  01:05:55  コミットを実行 → xe-0/0/14 に disable; が追加
            → ifAdminStatus down、ifOperStatus down

※ 障害の検知時刻と設定変更の時刻が一致さらに、レイヤーをまたぐ連鎖を順番に示してくれました。
L1 管理操作   QFX-01 xe-0/0/14 に disable
   ↓
L1 物理       対向の xe-0/0/30 は Admin up のまま Link down(波及であって故障ではない)
   ↓
L2 BFD        両端の BFD が Up → Down(Local diag: AdminDown)
   ↓
L3 BGP        IPv4・IPv6 の eBGP が両端で断(アラート 4 件)
   ↓
サービス 対向 AS への経路広告が停止加えて、同じ時間帯に出ていた無関係な障害 5 種類を、明示的に切り離して報告しています(11 時間前の別の eBGP 断、電源ユニットの縮退、温度のアラート、監視エージェントの疎通不可、テスト用のトリガー)。
かかった時間とコスト
| 項目 | 実測 |
|---|---|
| 所要時間 | 2 分 00 秒 |
| ツールの呼び出し | 9 回 |
| 消費トークン(応答) | 7,769 |
1 件あたり 1 万トークン弱で、待機中はゼロです。
通知と画面
メール
報告の全文が HTML のメールで届きます。アカウントが要らないので、外出先でも読めます。
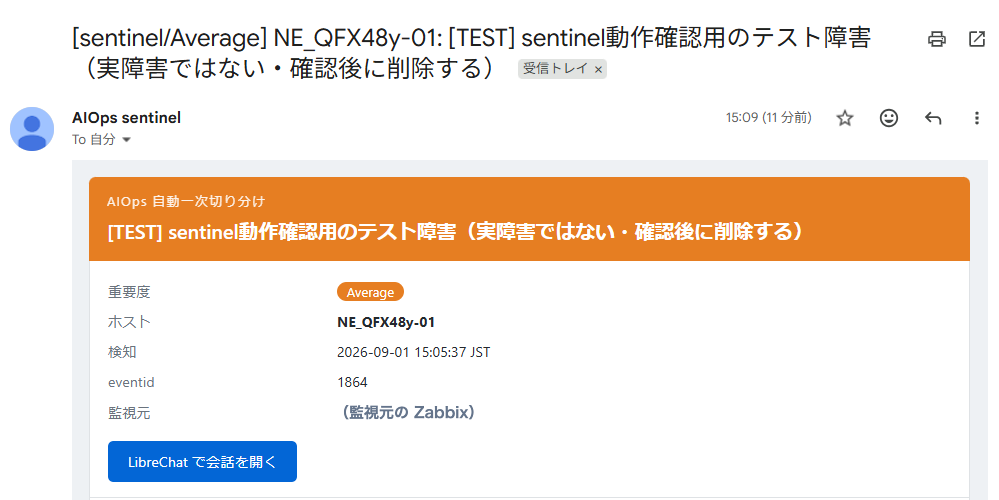
メールの「LibreChat で会話を開く」から、そのまま調査の会話に飛べます。
チャットで追加の質問ができる
LibreChat の会話にも同じ報告が入るので、ここで追加の質問ができます。「本当に人の仕業? syslog からもそう読み取れる?」と聞けば、AI が機器を調べ直して答えてくれます。
構成図に障害箇所を重ねる
自作の LabUI MCP が、構成図に「いまどこが落ちているか」を重ねてチャットの中に描きます。
- 障害のある機器 → 枠線を重要度の色にし、件数のバッジを付ける
- 障害の乗ったリンク → 赤の破線とポート番号
- 図の下に障害の一覧 → クリックすると、その場で AI に調査を頼める
最初は、構成図の向きや期間を指定できませんでした。チャットで頼むと、AI が「このツールでは指定できない」と説明したうえで、別の手段で描き直していました。
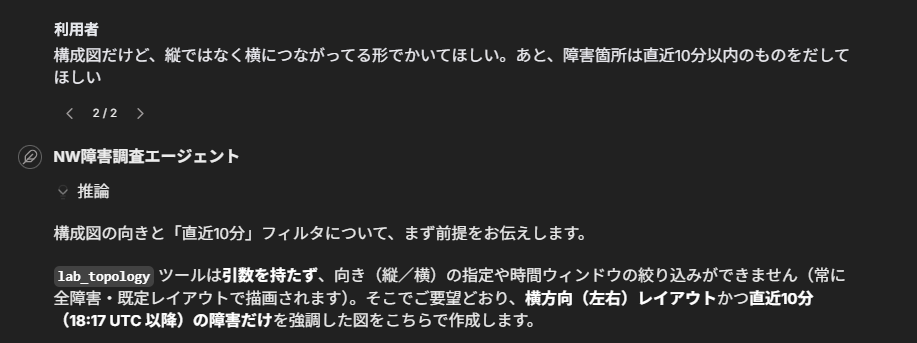
その後、向きや期間、機器の並び順を引数で指定できるようにしました。
図の描き方は言葉で指示できます。
「構成図を横向きで、直近 10 分の障害だけ」
  → lab_topology(layout='horizontal', since_minutes=10)
     障害 32 件 → 5 件、障害リンク 2 本 → 1 本 に絞り込み

「C891-01 を左端、C891-02 を右端、QFX はその間に。障害ポートの番号も」
  → lab_topology(layout='horizontal', order='C891-01,QFX,C891-02', show_ports='faulted')
まとめ(前編)
- Zabbix・NetBox・Ansible を MCP で AI につなぐと、「アラートを見て、機器に入って、原因を推定する」一次切り分けを AI が自分で組み立てられる
- 振る舞いを決めているのは、コードではなく Markdown の手順書 1 枚
- 常駐プログラムが障害を検知したときだけ AI を起こすので、待機中のコストはゼロ
- 「人が disable したのか、壊れたのか」を、config のコミット時刻まで突き止めて見分けられた
ただ、ここまで来るのは順調ではありませんでした。同じ手順書・同じ道具を渡しても、モデルによって正解率が 100% と 0% に分かれたこと、そして手順書の一文で AI の行動ががらりと変わったことなど、後編では作ってみて分かったことをまとめます。